Manutenzione predittiva dal segnale all'ordine di lavoro
Kinetia legge i segnali delle macchine, si accorge quando iniziano a cambiare prima che scatti la soglia fissa, spiega cosa sta succedendo con i manuali alla mano e prepara l'intervento. Gira nei vostri server, insieme al resto della suite AiDream.
Il principio: accorgersi prima della soglia
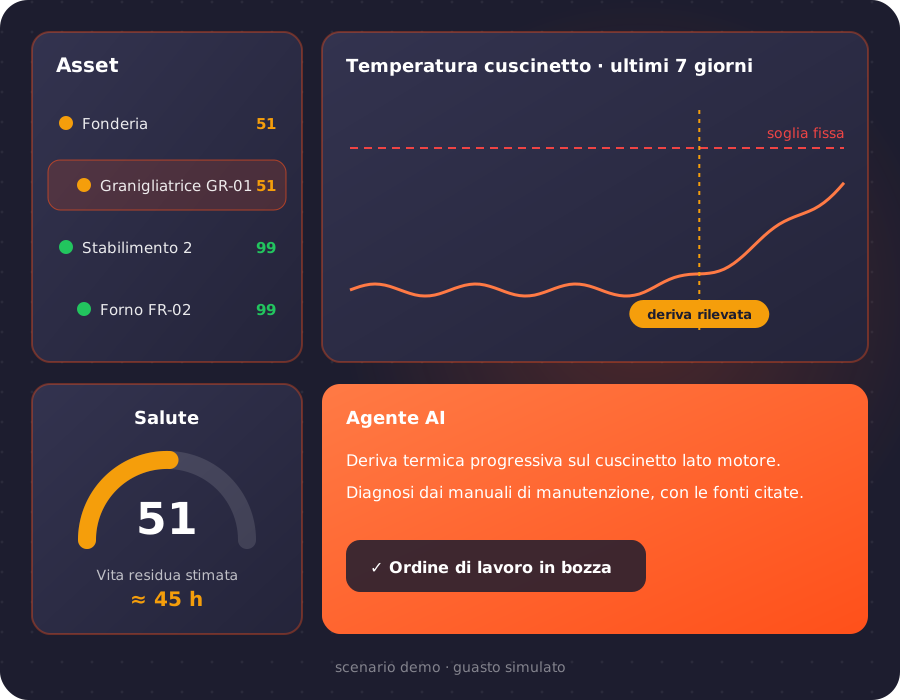
Un allarme a soglia fissa scatta quando il guasto è già arrivato. Kinetia impara come si comporta ogni macchina quando sta bene, cicli di turno compresi, e segnala lo scostamento quando è ancora piccolo. Poi non si ferma al segnale: lo traduce in una spiegazione, in una diagnosi e in un ordine di lavoro.
Derive, non solo picchi
Una temperatura che sale di poco ogni giorno non supera mai la soglia, finché non è troppo tardi. I rilevatori di Kinetia guardano proprio quella tendenza.
Ogni anomalia ha una spiegazione
L'agente AI descrive cosa è cambiato rispetto al normale e propone una diagnosi tratta dai manuali di manutenzione, con le fonti citate.
Tutto resta in fabbrica
Raccolta, archivio, modelli e intelligenza artificiale girano on-premise: i dati delle macchine non escono dal perimetro aziendale.
Dai dati di campo agli ordini di lavoro
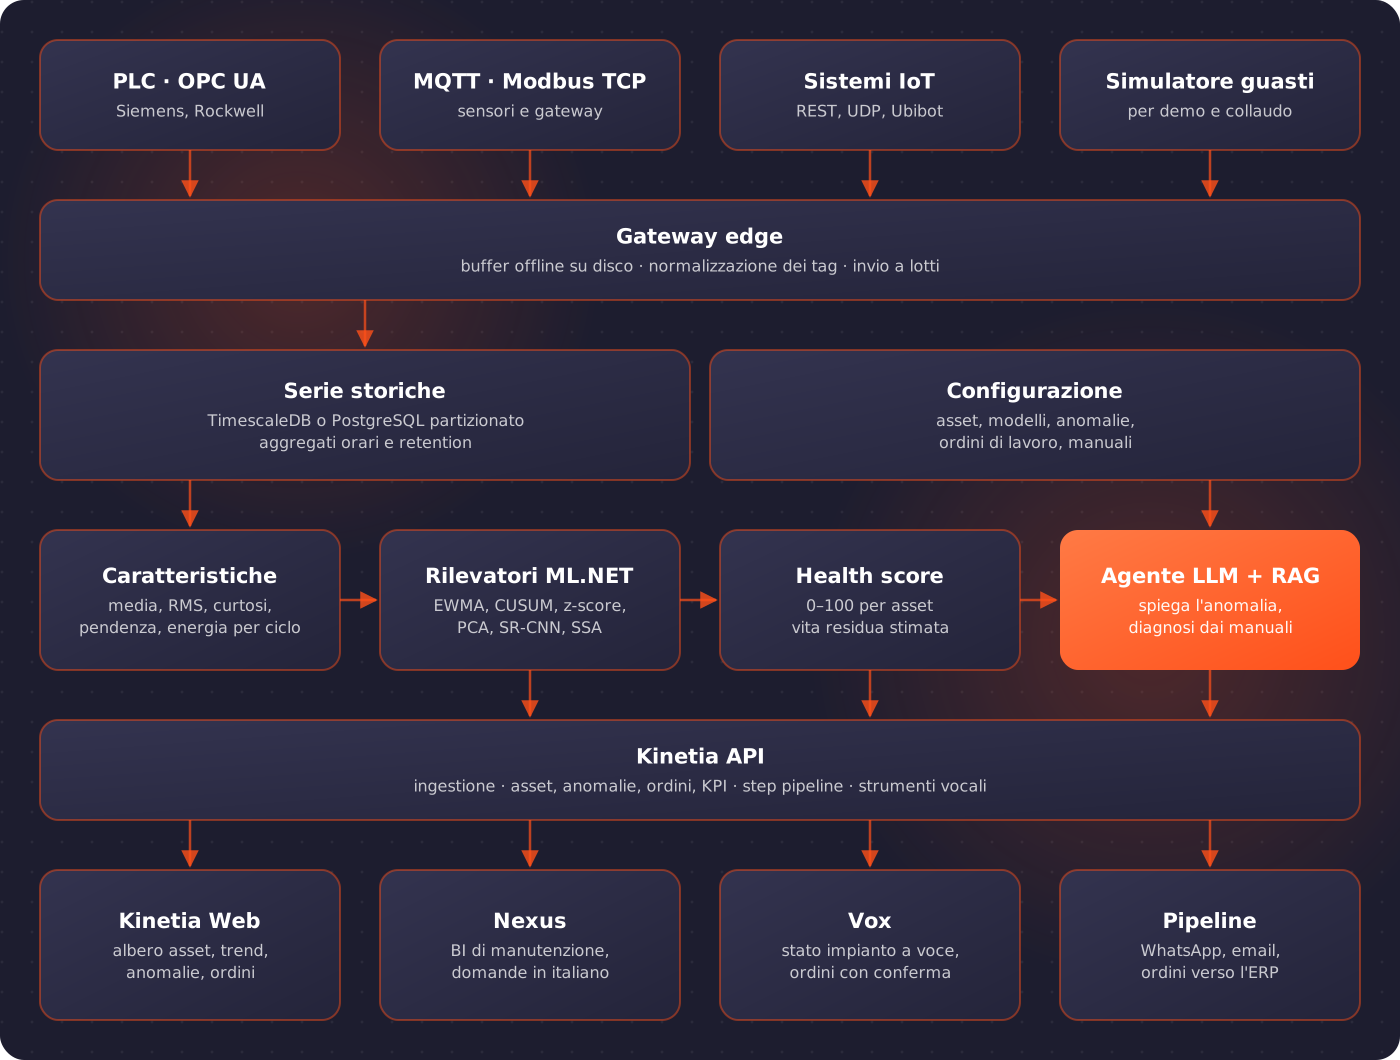
Un solo percorso: campo, gateway, archivio, valutazione, anomalie, AI, persone. L'agente LLM evidenziato è ciò che distingue Kinetia da un software di manutenzione tradizionale.
Cosa succede a ogni segnale
La valutazione gira di continuo, minuto per minuto, su ogni segnale che ha un modello addestrato.
Raccolta
OPC UA per i PLC Siemens e Rockwell, MQTT con topic e payload JSON, Modbus TCP, sistemi IoT già installati e un'API REST di ingestione.
Gateway edge
Un servizio installato vicino alle macchine scarica la configurazione, interroga le sorgenti e, se la rete cade, tiene i dati su disco finché non può inviarli.
Archivio
Le misure finiscono in TimescaleDB, o in PostgreSQL partizionato per mese dove l'estensione non è installabile, con aggregati orari e conservazione configurabile.
Rilevamento
Per ogni finestra si calcolano media, massimo, deviazione, curtosi e pendenza; i rilevatori confrontano il comportamento attuale con quello normale appreso dallo storico.
Salute e vita residua
Ogni macchina ha una salute da 0 a 100; linee e stabilimenti prendono la peggiore fra le loro. Con lo storico dei guasti si stima anche la vita residua.
Intervento
Spiegazione, diagnosi dai manuali, ordine di lavoro in bozza per le anomalie critiche e messaggio WhatsApp al manutentore.
Cosa fa Kinetia
Rilevatori tarati sui vostri dati
- EWMA per le derive, CUSUM, z-score robusto per i picchi, PCA multivariata per le combinazioni anomale, soglie fisse
- SR-CNN e SSA con ML.NET, sullo stesso stack .NET del resto della suite
- Soglie portate al 120% del punteggio più alto visto sui dati normali: i cicli di giornata e di turno non diventano allarmi
- Un'anomalia si apre solo dopo più finestre anomale consecutive, subito se un valore supera i limiti fissi
AI che conosce le vostre macchine
- Spiegazione in italiano: macchina, segnale, valore atteso, medie dei 7 giorni e salute
- Diagnosi con RAG sulla knowledge base dei manuali dell'asset, anche tradotti con Janus, con le fonti citate
- Bozza dell'ordine di lavoro con titolo, attività e priorità
- Modelli linguistici locali o connessioni AI già configurate nella suite
Manutenzione pianificata e su condizione
- Piani a calendario, a ore di funzionamento, a cicli o su condizione di salute e vita residua
- Ordini preventivi, correttivi e predittivi; chiudere l'ordine chiude l'anomalia
- Registro guasti con fermo, modalità e causa
- KPI di MTBF, MTTR, disponibilità e guasti anticipati da un'anomalia nei 7 giorni precedenti
Impara dal manutentore
- «Falso positivo» e «Guasto confermato» direttamente sulla pagina dell'anomalia
- Con falsi positivi ricorrenti il riaddestramento notturno alza la soglia del modello, con un limite
- I segnali con anomalie aperte non si riaddestrano, per non imparare il guasto come normale
- Le conferme diventano le etichette che servono alla previsione della vita residua
Dentro la suite AiDream
Kinetia è un modulo licenziabile di AiDream: usa lo stesso accesso, gli stessi servizi AI e parla con le altre applicazioni.
Nexus
Progetto «Maintenance BI» con asset, anomalie, ordini, MTBF e MTTR, interrogabile in linguaggio naturale.
Vox
«Qual è lo stato della linea 2?»: stato dell'impianto, anomalie aperte e nuovi ordini a voce, con conferma prima di creare.
Pipeline
Step dedicati per leggere le anomalie critiche, chiedere la diagnosi, creare l'ordine e inviarlo all'ERP, anche tramite Linko.
Notifiche
WhatsApp ed email al manutentore con spiegazione e diagnosi, attraverso gli stessi canali delle altre automazioni.
La demo, in cinque passaggi
Gira tutta in locale, senza una macchina reale: un simulatore riproduce l'usura progressiva di un cuscinetto su una granigliatrice da fonderia.
- 1
Il simulatore inietta una deriva lenta sulla temperatura del cuscinetto.
- 2
Il cruscotto passa da verde a giallo prima che scatti la soglia fissa, mentre le macchine sane restano fra 99 e 100.
- 3
Il manutentore riceve un WhatsApp con la spiegazione e la diagnosi tratta dal manuale della macchina.
- 4
Si apre l'ordine di lavoro in bozza; da Vox si chiede come sta la linea.
- 5
In Nexus la dashboard di manutenzione mostra affidabilità e fermi.
Nella demo la granigliatrice scende a salute 51 con una vita residua stimata di circa 45 ore, e il piano su condizione apre da solo l'ordine. Sono numeri di uno scenario simulato, non risultati di un impianto in produzione.
Come si adotta
Ogni passo chiude con una verifica concordata: se non passa, il successivo non parte. Il monitoraggio e le anomalie servono da subito; la previsione arriva quando ci sono i dati.
Pilota
Si scelgono una o due macchine con 2–3 modalità di guasto note, si censiscono segnali e storico e si fissano i KPI: anticipo della segnalazione, falsi positivi a settimana, fermi evitati.
Monitoraggio
Gateway e connettori in campo, dati reali nell'archivio, albero degli asset, trend, soglie e registro guasti. Il registro si compila dal primo giorno.
Anomalie
I rilevatori si addestrano sul comportamento normale e vengono validati sul pilota insieme ai manutentori, non solo sui grafici.
AI e integrazione
Manuali nella knowledge base, diagnosi, ordini di lavoro, notifiche, Nexus, Vox e collegamento all'ERP.
Previsione
Dopo alcuni mesi di guasti registrati la vita residua si tara sui casi reali e la manutenzione su condizione sostituisce il calendario.
Il resto dell'impianto
Kinetia si appoggia alle soluzioni Eulogika che raccolgono e raccontano i dati di fabbrica.
IOT DAQ WEB
Acquisizione dati e monitoraggio delle macchine in tempo reale, sorgente nativa per Kinetia.
Vai alla paginaNexus e Vox
La business intelligence conversazionale su cui gira la dashboard di manutenzione.
Vai alla paginaAiDream Suite
La suite AI modulare di cui Kinetia fa parte: documentale, agenti, automazione industriale.
Vai alla paginaDomande frequenti
Servono sensori nuovi per usare Kinetia?
Non sempre. Molti segnali utili, come assorbimenti, temperature, pressioni e tempi ciclo, sono già nei PLC e si leggono via OPC UA o Modbus. Per componenti come i cuscinetti può convenire aggiungere un sensore di vibrazione o temperatura via MQTT.
Servono anni di storico dei guasti?
No. Il rilevamento delle anomalie impara il comportamento normale e non ha bisogno di guasti etichettati, quindi funziona dal primo pilota. La stima della vita residua invece migliora con i guasti registrati: per questo il registro si compila dal primo giorno e la previsione arriva dopo alcuni mesi di dati.
Come si evitano i falsi allarmi?
Le soglie si tarano sullo storico normale della macchina, un'anomalia si apre solo dopo più finestre consecutive e il manutentore può marcare ogni segnalazione come falso positivo: con segnalazioni ricorrenti il modello alza la propria soglia nel riaddestramento notturno.
I dati e l'AI restano in azienda?
Sì. Gateway, archivio, modelli di rilevamento, knowledge base dei manuali e modello linguistico si installano on-premise. Il gateway di reparto non accede al database della suite: invia le misure all'API con una chiave dedicata.
Si collega al nostro ERP o al software di manutenzione?
Gli ordini di lavoro si inviano all'ERP con una pipeline, direttamente via API o attraverso il middleware Linko per SAP, AS400 e Business Central; il numero di documento restituito dall'ERP torna sull'ordine in Kinetia.
Proviamo Kinetia su una vostra macchina?
Partiamo da un pilota su una o due macchine, con KPI concordati prima di iniziare: anticipo della segnalazione, falsi positivi, fermi evitati.
Parliamone